我们习惯用一个整体指标去描述一个 learned model:它学得好不好、泛化强不强、是不是一个好的 prior。但有限数据留下的误差并不均匀。一个模型可能在某些区域很好地接近真实的 population structure,在另一些区域则保留更多 finite-sample error。与其把 prior 看成具有一个单一的“质量”,不如把它看成一张 reliability landscape。
下游过程也几乎不会均匀地使用这张地图。Posterior conditioning、prompting 和 search 都会改变模型实际被访问的区域;post-training 更进一步,不仅改变访问和优化压力,也可能直接改变地图本身。
这意味着,模型在具体任务中有多可靠,不只取决于全局 prior 质量,还取决于:这个过程把模型带到了哪里,而模型在那里究竟学得怎么样?有些 conditioning 把概率质量集中到误差较小的区域,finite-data error 几乎不显眼;另一些则更多地访问误差较大的区域,让原本局部的偏差被放大。
本文刻意拿掉神经网络、优化误差和近似采样,只保留 finite data 本身。即使在这样一个最简单的 setting 里,同样程度的 ambiguity、同样形式的 conditioning,也可能仅仅因为访问的位置不同,而面对数倍不同的误差。所以这里想强调的不是“prior 不可靠”,也不是“conditioning 会失败”,而是一种更基本的分析直觉:
脱离下游过程实际访问的区域,单独谈一个 prior “好不好”是不完整的。值得追问的是:当前的 conditioning,把模型带到了哪里,而模型在那里究竟学得怎么样?
1. 一个 population truth 完全可见的二维世界
考虑一个二维 Gaussian mixture。8 个 component 均匀排在圆环上,具有相同的权重和 covariance。使用最简单的 linear Gaussian path:
因为完整的 population distribution 已知,给定任意 noisy state ,population 下的最优 clean prediction 可以精确计算:
再从 population 中抽取有限数据 ,并把这份 training set 本身看成一个 empirical distribution。对应的 Bayes-optimal conditional predictor 同样可以直接写出:
可以把这理解成一个极端理想化的 setting:模型容量无限,优化完全成功,并且精确学到了 empirical distribution。
这里没有训练失败的问题。 与 之间剩下的差异,只来自 finite sampling。
2. 有限数据留下的不是单个误差,而是一张地图
定义
它衡量的是:在 noisy state 上,如果只能依赖这份有限数据,对 clean state 的 conditional prediction 会偏离 population oracle 多少。把这个量画到整个二维空间,误差并不是均匀分布的。有些区域里 empirical oracle 几乎和 population oracle 一致;另一些区域则偏得更多。
在较小的 上,这种空间结构尤其明显。此时 本质上是一个 bandwidth 很窄的 kernel smoother,每个位置主要由附近少量 training samples 决定。finite sampling 的局部涨落直接留下了局部纹理。随着 增大,kernel 逐渐变宽,更多 training samples 被平均进来,局部差异也随之平滑。
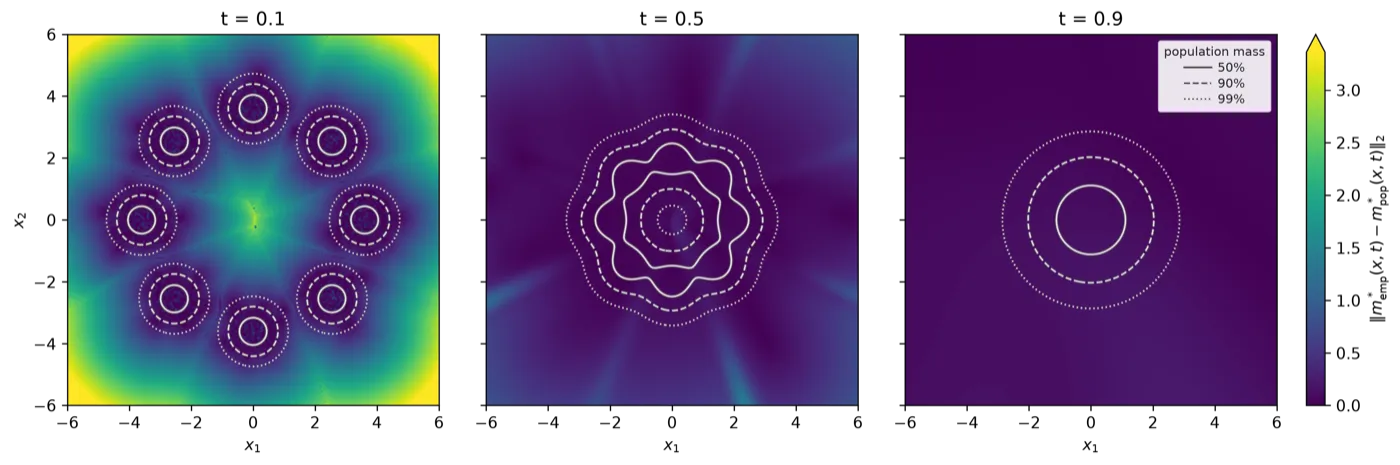
到了 , 与 完全独立。population predictor 退化为 population mean,empirical predictor 退化为 training set 的 sample mean:
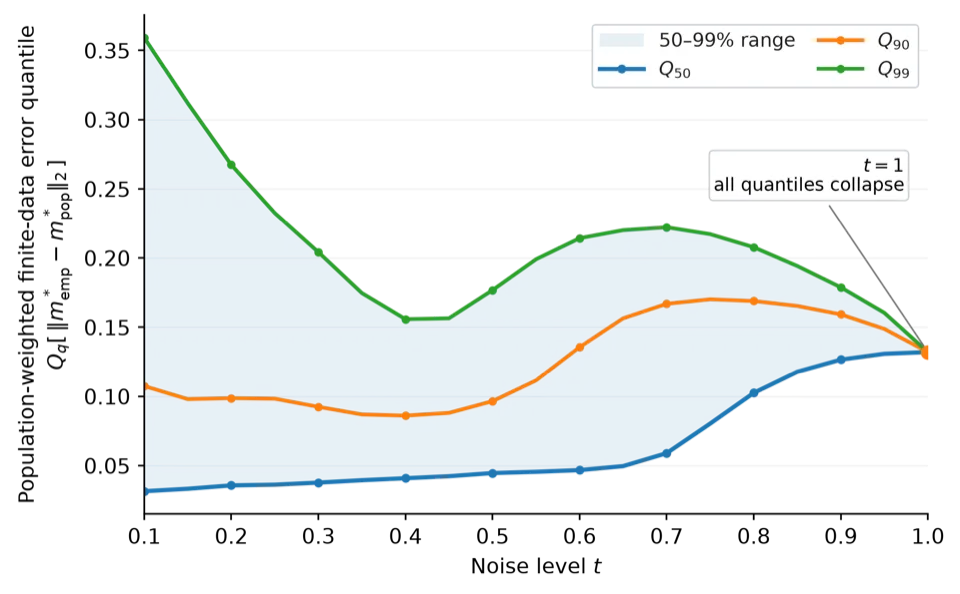
此时误差不再依赖位置,只剩下 training set 的 global sample bias。
所以随着 noising 进行,finite-data error 的空间结构大致经历:
这里变化的并不只是一个平均 error,而是整张误差地图的形状。
3. Conditioning 改变的是我们在地图上看哪里
现在加入一个简单的 observation:
measurement 只观测 的第一维。给定 后,可以精确得到 posterior path:
有限数据留下的误差地图 并不会因为 conditioning 而改变。改变的是 probability mass 在这张地图上的分布。因此,与一个 observation 相关的量,不是地图上某个位置的最大 error,而是 posterior 所覆盖区域里的平均 error。
定义 population baseline
以及给定 observation 后的 posterior risk
两者比值
描述了这个 observation 相对于 population baseline 所面对的 finite-data error。
时,posterior 更多地覆盖了高于 population-average error 的区域; 时则相反。同时,因为
有
Conditioning 不会在对所有 observation 平均以后凭空增加 finite-data error。它只是重新分配了这些 error。
在 时,按照 predictive distribution 加权, 的 median 约为 ,95th percentile 约为 。同一份 finite-data prior,在不同 observation 下暴露出来的平均 error 可以相差数倍。而这些 high-stress observation 并不一定来自 predictive distribution 的极端尾部。
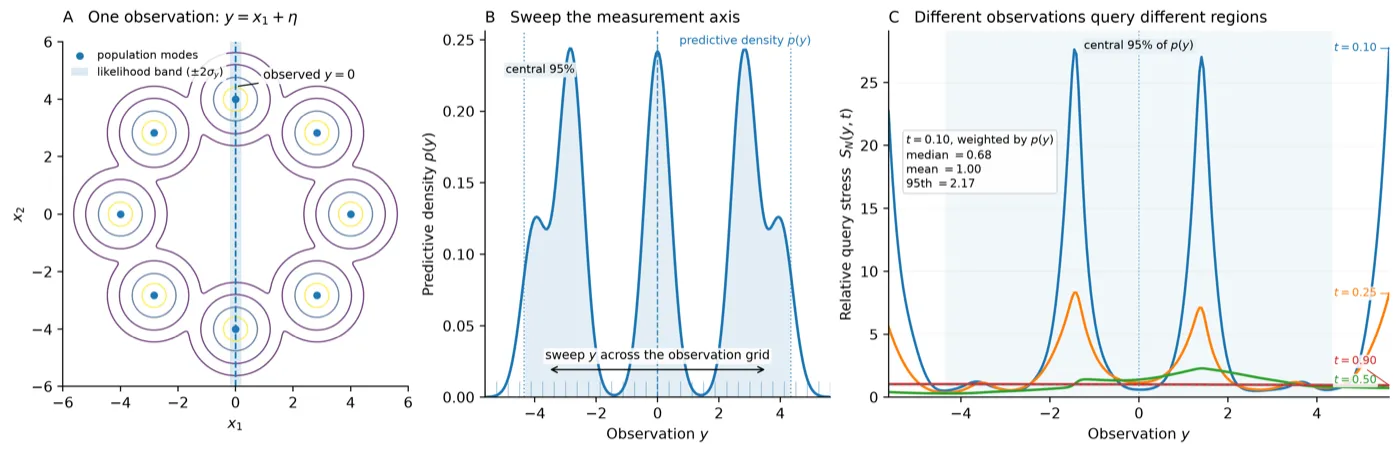
原因也不矛盾。地图上最大的 pointwise error 可以出现在低概率外围,但 比较的是 posterior 对整张地图重新加权之后的平均值。一个 observation 不需要把 posterior 推到最极端的 hotspot;只要它把更多 probability mass 放到了相对 population baseline 更差的区域,stress 就会上升。
4. 同样的 ambiguity,不同的 stress
一种自然的解释是:high-stress observation 可能只是产生了一个更加 ambiguous 的 posterior。
在这个二维 setting 里,可以直接控制这个因素。考虑两个普通的 observation:,。它们分别位于 predictive distribution 大约第 和 percentile,都很普通。在 时,对应的 stress 分别约为 和 ,相差约 倍。但两者对应的 posterior 在主要结构上几乎一致:激活相同的两个 mixture components,component weights 都是 ,effective component number 相同,conditional covariance 也相同。
它们主要区别在于位置。随着 改变,形状相同的 posterior 在 state space 中沿着 observation direction 平移。而 finite-data error landscape 并不具有同样的平移对称性。
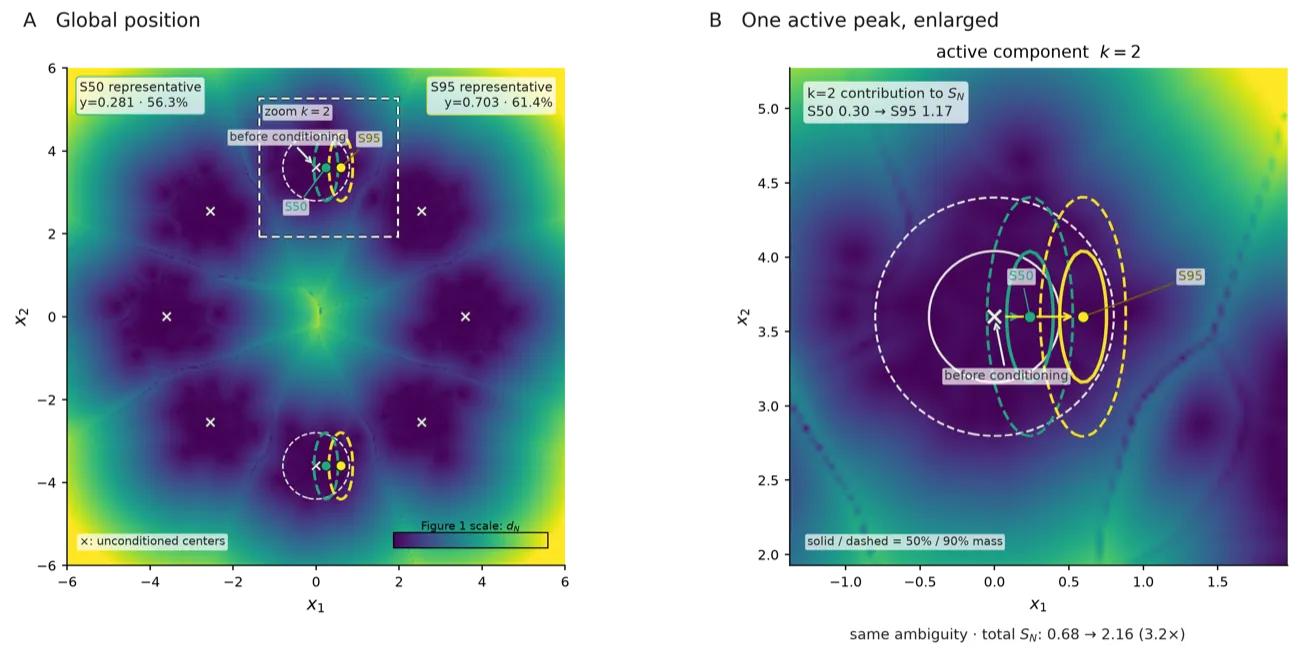
因此,一份 posterior 可以主要覆盖 empirical oracle 与 population oracle 较为一致的区域;另一份结构相同的 posterior,则可能落在 finite-data discrepancy 更明显的位置。Ambiguity 可以描述 observation 留下了多少不确定性。它并不能单独告诉我们,这些不确定性恰好落在 prior 的哪一部分。
5. Prior 的可靠性取决于它被怎样使用
这个 toy world 刻意把 function approximation、optimization error、architecture bias 和 guidance approximation 全部拿掉了,只留下一个最简单的问题:即使一个模型能够完美学习有限训练集所定义的 optimal predictor,finite data 本身是否已经足以让 prior reliability 变成一个 location-dependent quantity?在这个二维世界里,答案是 yes。而一旦 reliability 是 location-dependent 的,posterior conditioning 就自然多出一个值得问的问题:
这个 observation 到底让我们依赖了 prior 的哪一部分?
Conditioning 不会让 prior 变得更好或更坏,它只是重新分配概率质量,让我们站到地图的不同位置。误差的总量没有变,但被某个查询实际感受到的那部分,可以差出好几倍。